AudioBuff
打开即可使用。8 段 EQ、响度归一化、高质量导出,还有 Whisper 转录功能,全部在浏览器中完成。无需安装。
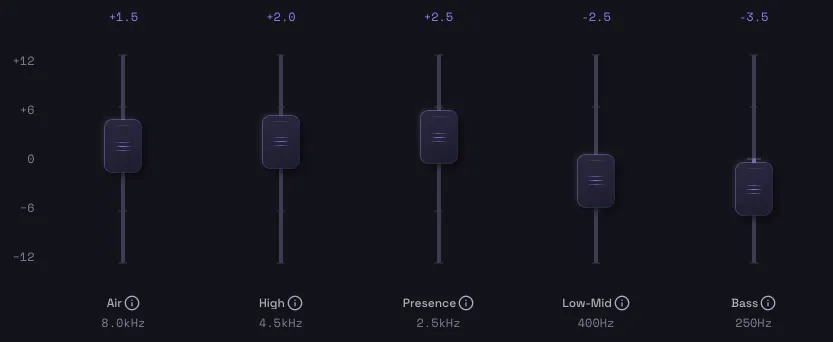
一切尽在浏览器中
专业音频处理,无需下载。
零安装
完全在浏览器中运行。无需下载,无需账号。打开网址即可使用。
8 段 EQ
6 段峰值滤波器 + 高架 + 低架滤波器,还内置高通滤波器。只需选择预设即可获得专业音质。
音量精修
压缩器均衡音量波动,并自动按 Spotify、YouTube、Apple Podcasts 的标准进行响度归一化。让声音清晰易听,并适配各平台要求。
裁剪多余部分
自动检测并裁剪 2 秒以上的静音。也可在波形上手动修整并添加淡入淡出。裁剪处保留 500 毫秒余量,效果自然。
转录(Whisper)
在浏览器中运行 OpenAI Whisper。支持日语和英语,可导出 SRT、VTT、TXT 格式。还能从转录结果中一键裁剪对应片段。
语音生成(测试版)
在浏览器中运行 Chatterbox,通过 10-20 秒的参考音频克隆声音。将文本转换为自然语音,并可直接用 EQ 加工导出。
高质量导出
支持导出 MP3(最高 320kbps)或 WAV。可批量处理多个文件并一键下载。
前后对比
一键切换处理前后的音频进行对比试听,直接用耳朵确认效果。
无限制,完全免费
没有文件大小或次数限制,没有水印,支持商用,永久免费。
隐私优先
不上传至服务器
文件绝不会发送到服务器。所有处理都在浏览器本地完成。
本地处理
音频处理基于 Web Audio API,转录基于 WebGPU/Whisper,语音生成基于 Chatterbox,均在浏览器内运行。首次下载模型后甚至无需联网。
无需账号
无需注册或登录,打开网址即可使用。
常见问题
AudioBuff 免费吗?
是的,完全免费。无需注册账号,无需信用卡,也支持商用。
我的音频文件会上传到服务器吗?
不会。所有处理都在浏览器内完成,文件绝不会发送到服务器,完全保护您的隐私。
支持哪些文件格式?
输入格式:MP3、WAV、OGG、FLAC、AAC、MP4。输出格式:音频可导出为 MP3(最高 320kbps)或 WAV,转录文本可导出为 SRT、VTT、TXT。
转录功能是如何工作的?
OpenAI 的 Whisper 模型直接在您的浏览器中运行。仅首次使用需要下载并缓存模型,之后可离线使用。音频不会发送到服务器。
转录支持哪些语言?精度如何?
支持日语和英语。精度取决于音频质量和语速,可在标准模型(whisper-small)和高精度模型(large-v3-turbo)之间选择。支持 WebGPU 的设备处理速度会更快。
可以从转录结果中裁剪不需要的部分吗?
可以。每个转录片段都有一个剪刀按钮,点击一下即可将对应区间标记为导出时排除。非常适合删除口头禅和冷场部分。
语音生成是如何工作的?
Resemble AI 的 Chatterbox 模型完全在浏览器中运行。通过 10-20 秒的参考音频克隆声音特征,再由文本生成语音。模型仅首次下载(约 1.5GB)并缓存,之后可离线使用。音频和文本都不会发送到任何服务器。
语音生成支持哪些语言?有什么注意事项?
目前仅支持英语(测试版)。生成的音频始终嵌入 Resemble Perth 水印,可供事后验证为 AI 生成。出于伦理考虑,请仅使用本人声音或已获得明确授权的声音。
EQ(均衡器)是什么?
是一种调整音频各频段音量平衡的工具,可以让浑浊的声音变清晰,或增加低音的厚度。只需选择预设即可自动应用设置,无需专业知识。
可以在手机上使用吗?
可以,支持移动端浏览器,iPhone 和 Android 均可使用。
可以用于哪些场景?
播客、音乐、视频旁白、语音备忘录、直播音频等,适用于各类需要打磨的音频内容。
现在就开始打磨你的音频。
无需下载,无需账号。